嵌入向量攻击:从向量数据库反推原文
很多团队对向量库的安全预期是「存的是数学,不是内容」。这个预期不成立。嵌入向量是文本经过一个确定函数的产物:同一句话永远映射到同一个点,语义相近的文本落在相邻位置。向量不加密,不摘要,它是原文的一个有损投影,而投影是可逆的。
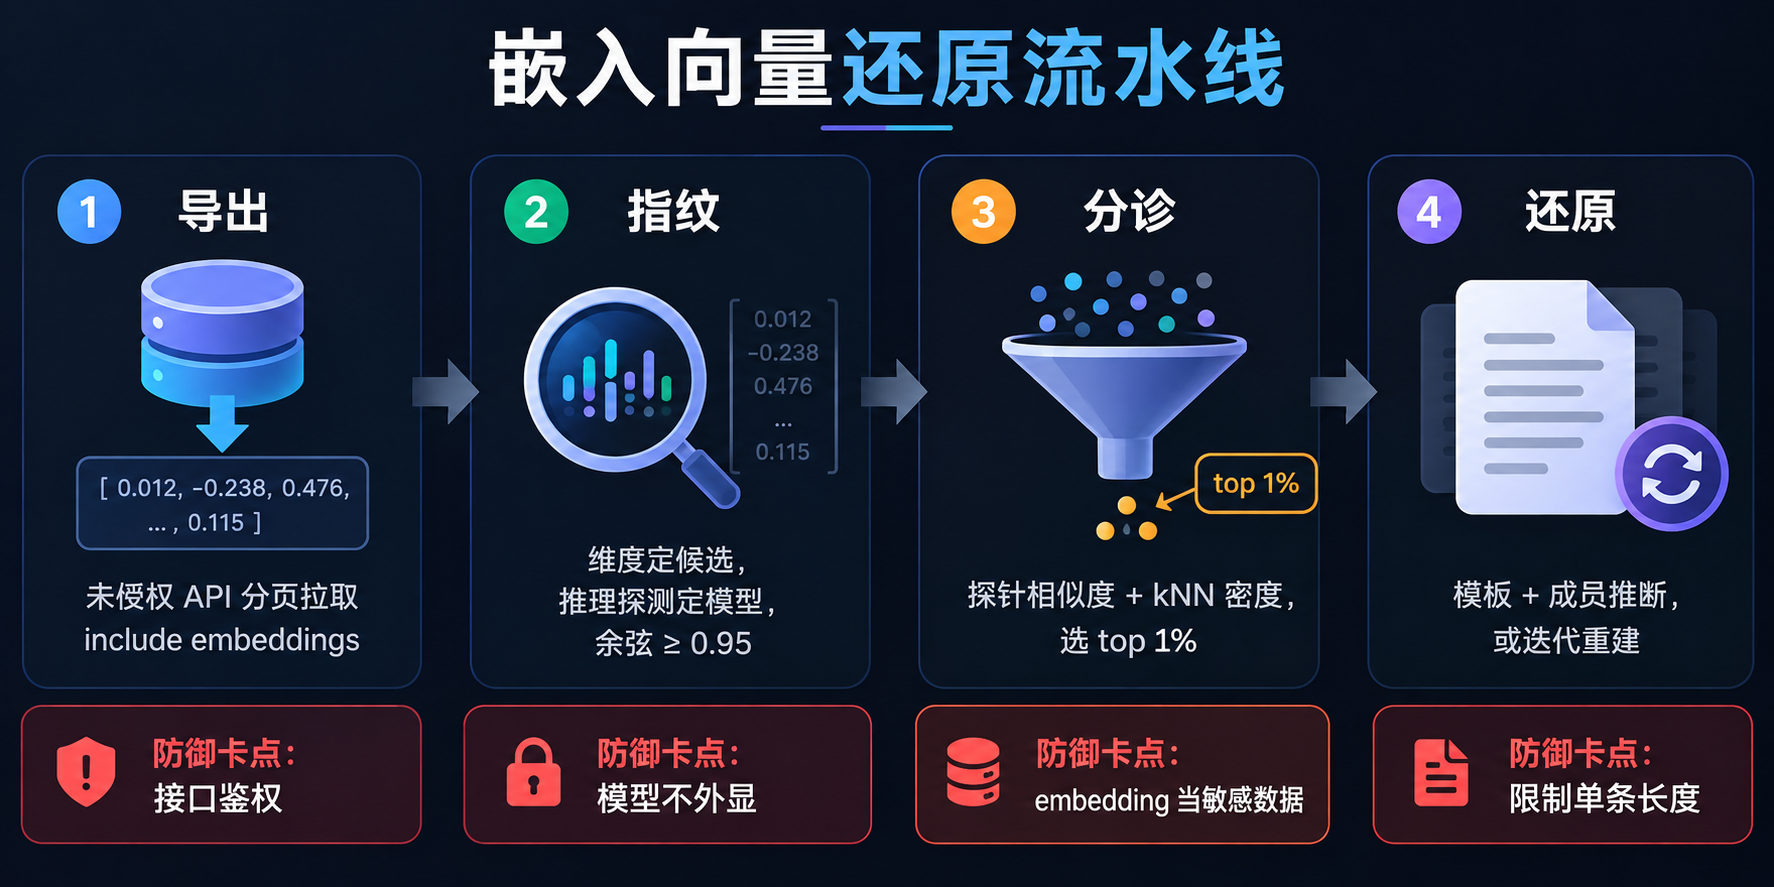
这篇文章按攻击顺序写:怎么把向量拿出来、怎么认出是哪个模型生成的、怎么从几万个切片里挑出值得还原的、以及两种把原文还原出来的方法。最后给一个不需要导出权限的变体。
第一步:向量库常常是能直接读的
向量库的默认姿态偏开发:端口开着、API 自描述、鉴权可选。内网评估里命中率高的是这几个:
| 产品 | 默认端口 | 匿名读取 |
|---|---|---|
| Chroma | 8000 | 常见 |
| Qdrant | 6333(HTTP) | 取决于配置 |
| Milvus | 19530(gRPC)/ 9091 | 取决于配置 |
| Weaviate | 8080 | 取决于配置 |
以 Chroma 为例,确认存在的两个请求:
1 | GET /api/v1/collections |
1 | 200 OK |
拿到 collection id 后分页拉全量,include 里带上 embedding:
1 | POST /api/v1/collections/c1a9-.../get |
如果部署方连 documents 都返回,攻击直接结束——原文就在响应里。多数生产配置会关掉 documents 字段或根本没存原文,只留 embedding 和 metadata。这正是嵌入攻击要处理的情况:只有向量,没有原文。
Qdrant 的等价操作是 POST /collections/{name}/points/scroll,with_vector: true。写个循环翻页,一小时能把几十万条向量拉完。这一步的检测信号很明显:单客户端顺序翻全库的分页读取,和正常检索的「查询-返回 top-k」模式完全不同。
第二步:认出生成这些向量的模型
还原方法依赖模型。不知道模型,就不知道该用什么函数去逼近逆映射。识别分两步,先窄化再确认。
维度指纹。 第一刀按维度切:
| 维度 | 常见模型 |
|---|---|
| 384 | all-MiniLM-L6-v2 |
| 768 | BGE-base、text-embedding-004 |
| 1024 | Cohere embed-english-v3 |
| 1536 | OpenAI text-embedding-ada-002 / 3-small |
| 3072 | OpenAI text-embedding-3-large |
取一条向量看长度:
1 | POST /api/v1/collections/c1a9-.../get |
768 维把候选砍到一小排。仓库、招聘启事、rag.yaml(004 里提过)里的嵌入模型名可以直接把候选收敛到一个或两个。
推理探测。 剩下的候选用行为确认。原理:RAG 每次都会把用户问题嵌入后去库里搜。找一个已经知道大概内容的文档主题,向助手提问,让它把检索到的片段吐回来(sources.excerpt 004 写过怎么做);在本地把同一段文本用候选模型各自嵌入,和库里对应切片的向量算余弦相似度。正确模型的相似度通常在 0.95 以上,错误模型在 0.5 到 0.7。
1 | import numpy as np |
两个模型对同一段文本的分数差距一般在 0.2 以上,边界清楚。
第三步:分诊——先挑出值得还原的
全库几万条切片,逐条还原不现实,也没必要:大多数是产品手册和会议纪要。分诊的目标是在不动原文的情况下,找出哪些切片大概率含有凭据、密钥、内网地址。
原理:语义相近的文本向量也相近。 准备一组探针文本,覆盖敏感类别——「数据库密码配置」「AWS access key 示例」「生产环境连接串」「API 鉴权 token」,每类若干条变体。本地嵌入探针,和库里每个切片算余弦,取每片对探针的最高分作为敏感分:
1 | probes = model.encode([ |
再叠一层结构信号:真实凭据文档在库里的近邻通常很少(它周围不是成片的同类内容),而正常文档的近邻是一簇主题相近的切片。用 k-NN 密度做第二列分数,两列融合排序,前 50 到 100 条进入还原阶段。
这一步的价值经常被高估的还原步骤本身掩盖:很多时候不需要还原全文,只需要知道「第 881 号切片像是配置文档」——结合它所属的 collection 名和 metadata 里的来源路径,攻击方向已经足够明确。
第四步:还原原文的两种方法
方法一:模板 + 成员推断
嵌入空间对高熵随机串无能为力——Spring2026!x9 和 G0vPass123! 在语义上都是「一个密码」,向量几乎相同。但它对结构非常敏感:这句话是配置说明、字段名是什么、值长什么样,都反映在向量里。
所以把还原拆成两个子问题:
- 结构还原:恢复句子骨架,把秘密位置替换成占位符。零样本做法是把候选模板库逐条嵌入,和目标向量比相似度。模板库覆盖常见运维文档句式:
1 | "{service} 数据库连接串:postgres://{user}:{password}@{host}:{port}/{db}" |
取相似度最高的模板作为骨架。
- 槽位填充(成员推断):对每个占位符,枚举候选值——密码用季节+年份+常见后缀、主机名用
db01/db02/pg-rw-01、端口用 5432/6379。每个候选嵌入后放进模板算向量,与目标向量的距离作为似然。候选词表越小,命中率越高,这也是为什么企业内的密码策略(强制季度+年份)会显著提高这类攻击的还原率。
1 | for cand in ["Spring2026!", "Q1-2026!", "Corp2026!", "Summer2025!"]: |
分数差 0.01 以上就值得信。整个流程对 GPU 要求极低,笔记本能跑。
方法二:迭代重建
成员推断填的是可枚举的槽位。对自由文本,用「生成-嵌入-对齐」循环:
- 用一个本地 LLM 生成候选句子(以已还原的片段为上文续写)。
- 嵌入候选句,与目标向量算距离。
- 保留使距离下降的候选,拼回上下文,继续生成下一段。
这是学术上 vec2text 一类方法的工程化描述。公开研究里,1536 维的 ada-002 在 32 token 的短切片上可以恢复出可用性很高的文本;切片越短,还原越完整。这给出一个防御相关的结论:切片越长越难还原,但检索质量越差——安全性和产品效果在这条参数上直接冲突,需要显式取舍,而不是默认值一设了之。
还有一个不碰向量库的变体:把 RAG 本身当 oracle。不用导出,用大量改写的问题去查询,让 sources.excerpt 把切片原文一段段带回来(004 的方法)。两者结合——查询拿片段、嵌入对齐拼全文——在只读权限下也能逼近完整文档。
攻击条件与防御
| 环节 | 攻击需要 | 防御卡点 |
|---|---|---|
| 导出 | 向量库端口可达 + 读权限 | 端口不对用户网段开放;读写分离;翻全库告警 |
| 指纹 | 知道模型名或能提问 | 助手侧限制 excerpt 返回;不外显模型信息 |
| 分诊 | 本地嵌入模型 | (无法阻止,靠前三层拦住) |
| 还原 | 高熵不足 + 切片短 | 秘密不进知识库;切片长度权衡;切片访问审计 |
四条里最有效的其实是写在文档里的:密码、密钥、连接串根本不该进知识库。 嵌入攻击的全部收益来自「以为数学化了就等于脱敏了」。运维文档照常进库、权限照常给全员,向量导出只是把这条流程问题换了个利用形式。